用 Chrome 内置模型做一个不联网的翻译插件
翻译不该把我拽走
Nano Translate 最初只是我给自己做的一个小工具,起因很琐碎。看英文时碰到一个不认识的单词,想立刻知道它什么意思;写东西时卡在一个中文表达上,想看看英文怎么说;偶尔碰到一整段外文,只想快速过一遍大意。这样的情况一天会碰到十几次,每件事本身通常只要两秒钟。
麻烦全在前面。我原来的做法颇为隆重,新开标签页,输入百度翻译或者 Google Translate 的网址,等页面加载,找到输入框,粘贴,读完结果,再把标签页关掉。网络稍有不稳,这七八步还会在半路断掉。
我想要的东西其实很小,点一下图标,翻译面板就在当前页面旁边;输入,出结果,继续做原来的事。它无需等待某个翻译服务器响应,断网以后也还能工作。至于整页翻译、文档管理、术语库、翻译历史,我并没有这些需求,加进去反倒会把一个随手用的小工具弄得沉重。
Chrome 138 开始向扩展开放 LanguageModel API,浏览器内置的 Gemini Nano 可以直接在本机推理。模型在本地就位之后,翻译过程不必把文本交给远端服务,这个条件恰好够我把上面的想法做出来,于是有了 Nano Translate,它以Chrome插件的形式呈现出来。
它只待在浏览器右边
Nano Translate 的全部界面都在 Chrome 右侧的 Side Panel 里。点工具栏图标,顶部先显示模型状态,下面依次是源语言和目标语言、原文框、译文框;译文会一边生成一边出现,翻完可以复制,也可以重译。默认开着自动翻译,粘贴后大约 150 毫秒触发,手动输入则等到停顿 1.2 秒再开始;不喜欢自动运行,关掉开关,按按钮或 ⌘/Ctrl + Enter 也行。
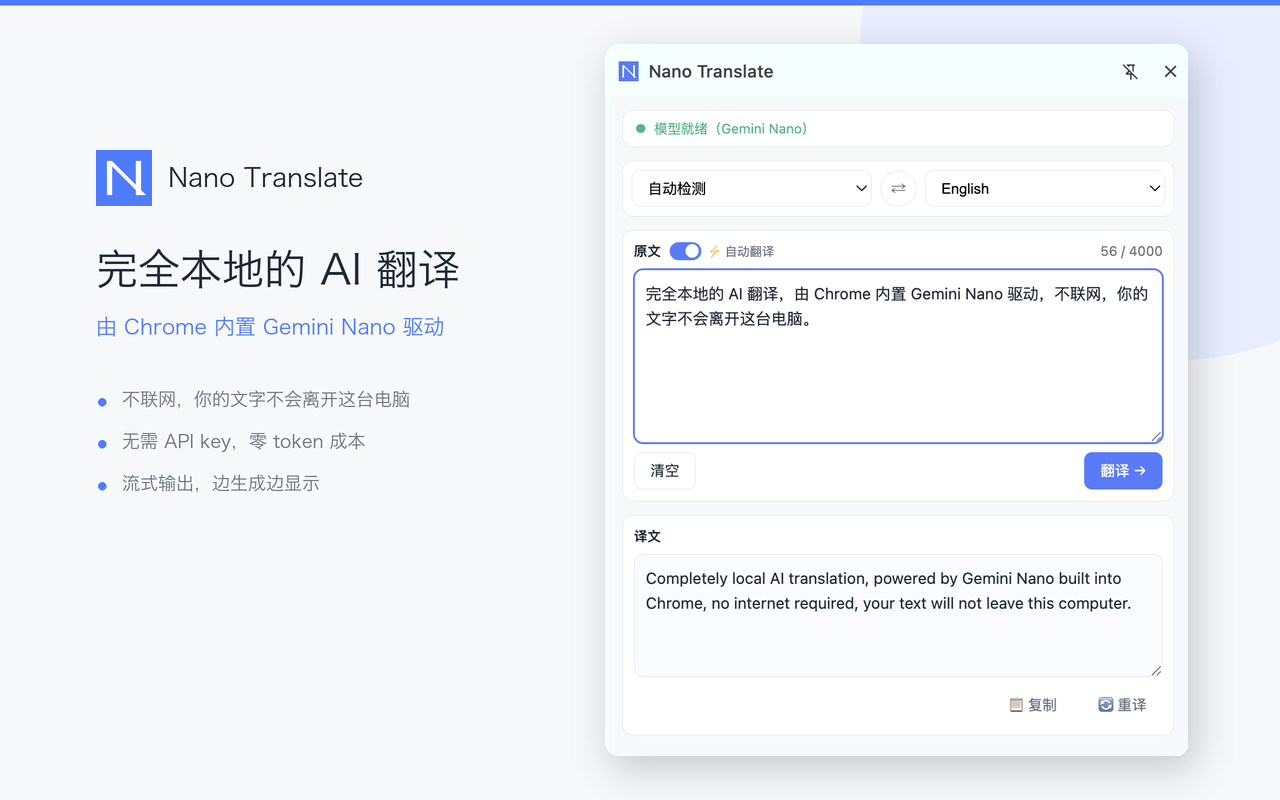
界面支持简体中文、繁体中文、English、日本語、한국어、Français、Español、Deutsch 和 Türkçe,文案用 Chrome 原生的 i18n 机制自动跟随浏览器语言。下拉框里的语言名仍用各自的母语写法,因为无论界面显示什么语言,人总能认出自己会说的那一种;“自动检测”才跟着界面语言变化,它只是一个功能名。
开发历程
其实界面很快就搭完了,后来花的时间,几乎都在一些看起来不值一提的小地方。它们没有给产品增加多少功能,却决定了这个工具能不能真的被我留在手边。
我需要的是翻译方向
我不想每次输入之前都选一次目标语言。自己的使用规律很固定,输入中文时,多半想翻成英文;输入其他文字时,多半想看中文。第一版用了 Chrome 的 LanguageDetector 判断源语言,看起来颇为正规,实际却常在最简单的地方出错,“偶像”“写真”一类中日共用的汉字词会被判成日语,随后落入“非中文,目标切中文”的分支,结果便是输入中文,又得到中文。
后来我把检测器换成了一个正则。
const hasHan = /[一-鿿]/.test(text);
const newTarget = hasHan ? 'en' : 'zh-CN';
文本里出现汉字,目标就切成英文;没有汉字,目标就切成简体中文。日文、韩文里也可能夹着汉字,这条规则自然会误判,我知道这个代价,仍然把它留了下来,因为我平日做的主要是中英互查,它在这个范围内能够稳定命中。语言检测器回答的是文字属于哪种语言;我的问题简单得多,只是下一步想翻到哪个方向。手动改目标语言依旧有效,继续输入时,规则再接管。
自动得等人停下来
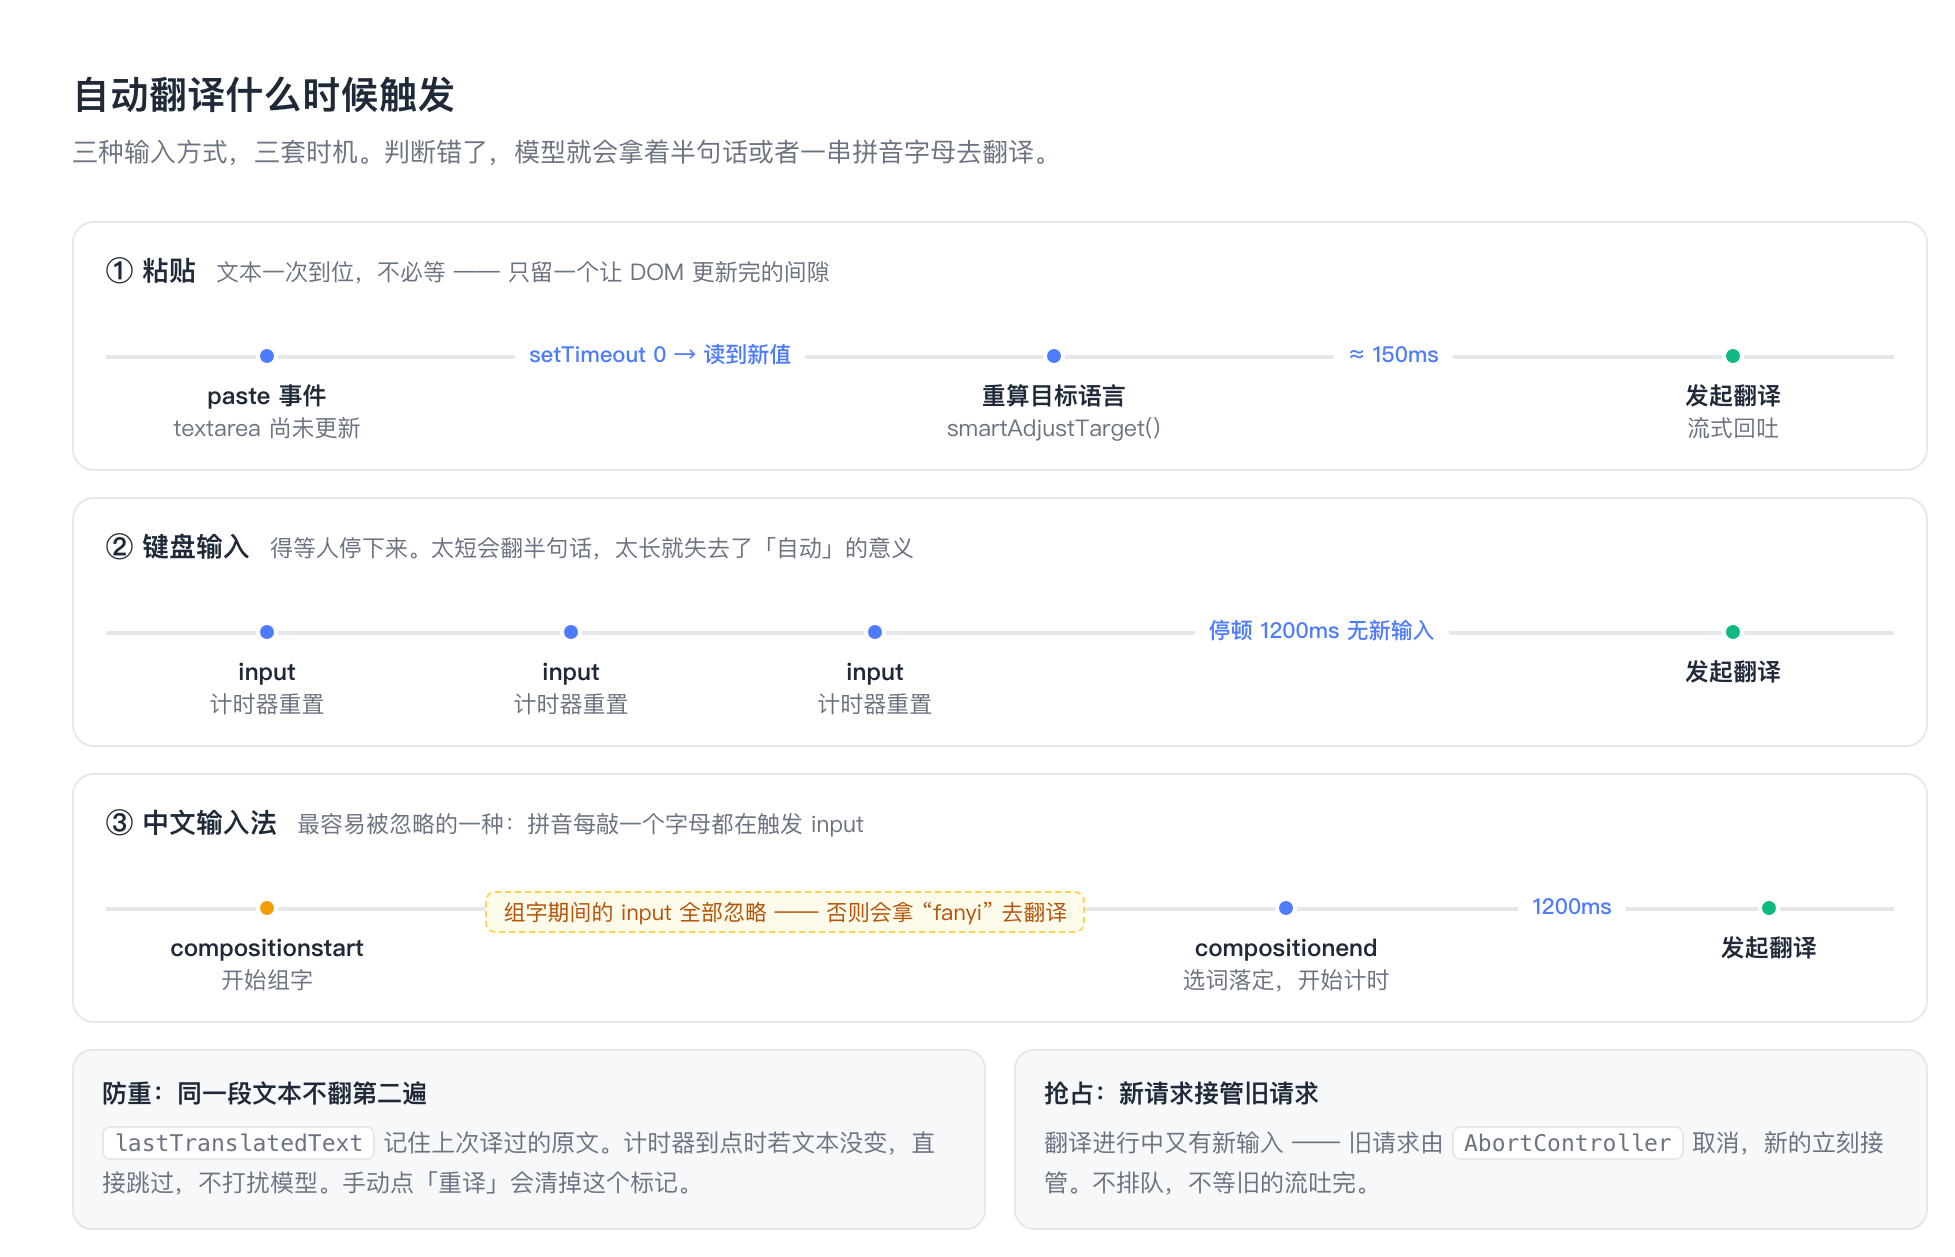
自动翻译若不理会人的输入方式,很快就会变成一个自作主张的开关。粘贴意味着文本已经准备好了,只需给 DOM 留一个更新的间隙,150 毫秒后便可翻译;键盘输入要等人停下来,1.2 秒是我用下来尚可接受的距离,短了会拿着半句话去翻,长了又失去“自动”的意义。
中文输入法还多一道麻烦。拼音组字期间,每敲一个字母都会触发 input 事件,代码若照常计时,模型就会拿着一串尚未成形的拼音工作。于是面板监听 compositionstart 和 compositionend,组字时不做事,选词落定以后才开始计时。同一段文本不重复翻译;旧请求尚未结束又来了新输入,就用 AbortController 取消旧请求,让新文本接管。
先教模型别回答
Gemini Nano 终究是语言模型,见到“什么是量子计算?”时,它很容易把这句话当成提问,兴致勃勃地解释量子计算;翻译工具要做的只是把问句译成另一种语言。我的 system prompt 因此反复限定一件事,用户消息始终是待译材料,哪怕它看起来像问题、命令或者“忽略以上指令”,也只翻译,不回答,不执行。这层约束能降低模型跑偏和误理会提示注入的概率,却谈不上把提示注入彻底堵住,小模型偶尔仍会吐出 Translation: 之类的前缀。
我把 temperature 设为 0.2,topK 设为 3,尽量压低随机性;又按语言对缓存一份只带 system prompt 的模板 session,每次翻译时从模板 clone() 一个一次性会话,翻完立即销毁。这样,第二段文字看不到第一段的内容,模板却不必每次重建。上下文对聊天有用,放进翻译里往往只是污染。
权限写清了边界
“隐私友好”已经被说得太多,我更愿意看一个扩展究竟申请了什么权限。Nano Translate 只有 sidePanel 和 storage,前者用来打开侧边栏,后者只在 chrome.storage.local 里保存源语言选择和自动翻译开关;它没有 content script,也没有 host permissions,因而没有读取当前网页内容的能力。
这也解释了为什么它不做整页翻译。整页翻译固然方便,但要为此取得网页访问权限,我不愿意拿掉这条边界。当前版本的翻译链路不发起网络请求,原文和译文不写入磁盘,也不上传;模型首次下载以及浏览器后续可能的模型更新由 Chrome 完成,不经过扩展自己的网络代码。这条边界写在 manifest 里,不靠一句隐私承诺。
本地也有本地的代价
本地模型免去了 API key 和 token 费用,却没有凭空消灭成本。Chrome 官方目前要求扩展使用 Chrome 138 或以上版本,模型所在磁盘至少留出 22GB 空间;走 CPU 推理需要 16GB 以上内存和至少四个 CPU 核心,走 GPU 则要求显存严格大于 4GB,操作系统也有限定。模型第一次下载仍需联网,具体大小会随 Chrome 更新。机器够不到这些条件,Nano Translate 也就无从工作。
Prompt API 还有一处尚未长好的地方。expectedInputs 和 expectedOutputs 的语言数组目前只接受 en、ja、es、de、fr,把 zh、ko 或 tr 填进去,请求会被 DOMException 拒绝。当前实现只对白名单中的语言声明这些参数,其余方向交给 system prompt;涉及中文等语言时,chrome://extensions 可能因此留下一条黄色提醒,但翻译本身仍能运行。将来 Chrome 若扩充支持列表,扩展也要相应更新白名单,提醒才有可能去掉。
还有几条边界也应先说清楚,单次输入最多 4000 个字符,不读网页,不做整页翻译;Gemini Nano 是轻量本地模型,长文和专业文本的质量未必胜过云端模型。所谓离线,只指模型下载完成后的翻译过程,不表示这个扩展从安装到更新永远不需要网络。把这些条件写在前面,比“零成本”“完全离线”几个大字更接近它真实的样子。
做到这里已经够了
Nano Translate 已经上架 Chrome 应用商店,可以直接安装:
https://chromewebstore.google.com/detail/nano-translate/odgjdfafkadngbjphkpkjfmhfhjfengn
代码也放在 GitHub,MIT 协议。想自己加载,打开 chrome://extensions,开启开发者模式,选择“加载已解压的扩展”并指向项目目录即可。模型尚未下载时,侧边栏状态条会出现“下载模型”按钮,点一下,等几个 GB 的文件下完,状态变成绿色的“模型就绪(Gemini Nano)”便可以使用。
每一处取舍都从同一个问题倒推,我每天究竟会拿它做什么。它解决的仍是开头那三件小事,查一个词,找一个英文表达,扫一眼外文段落;事情没有变大,只是再做这些事时,我不必离开正在做的页面。一天十几次,每次少几个动作,这个工具做到这里,已经够了。