AI 视频二创,不能只看逐字稿
之前推文有谈过如何做文生图系统,这一篇聊聊如何用AI做视频二创。
实际上把一条视频交给大模型,再让它分析爆点、模仿结构、写出新稿,这件事听起来已经简单到了近乎没有技术含量。上传、等待、复制,三步齐活。我最初也这么想。实际做下来才发现,许多产品口中的“AI 看视频”,后台拿到的只有一份语音转写;模型说开头抓人,却讲不清是哪句话、哪一帧抓人,说中段情绪上升,也拿不出动作、字幕和切镜的时间。它没有看见画面,却又在评论画面,就会导致很强的撕裂感。
于是在本地尝试做了一个 Codex Skill,名称叫 short-video-remix。它接收本地 MP4,或小红书、抖音、B 站链接,把视频整理成字幕、关键帧和统一时间线,再交给 Codex 完成原片分析、结构提炼、二创方向、脚本与分镜。需要额外说明的是,关于小红书、抖音、B站视频下载工具,依赖于第三方工具,不在本文的详述范围内。
AI 看见了什么
视频理解大致有几种办法:
- 字幕优先的方案先取得字幕轨、OCR 或 ASR 逐字稿,再交给文字模型处理,开源项目
video-copy-analyzer属于这一类,便宜、快速,适合口播和访谈,不过人物动作、构图和视听反差容易漏掉。 - Gemini、Qwen 一类原生视频模型可以直接接收视频,使用方便,但内部抽帧策略和中间结果往往不易复查。
- 开源项目
viral-video-breakdown展示了混合处理的思路,把视频、关键帧、逐字稿和分析结果都保存下来;更完整的商业内容系统还会叠加播放、完播、评论、账号基线和投流数据。
在制作 short-video-remix 时选择了混合方案。下载、媒体探测、抽帧、转录和时间对齐交给脚本,因为这些事情有明确答案;Codex 负责看图、理解结构、解释视听关系和创作新内容,这些步骤需要理解与选择。
系统中的数据流如下。
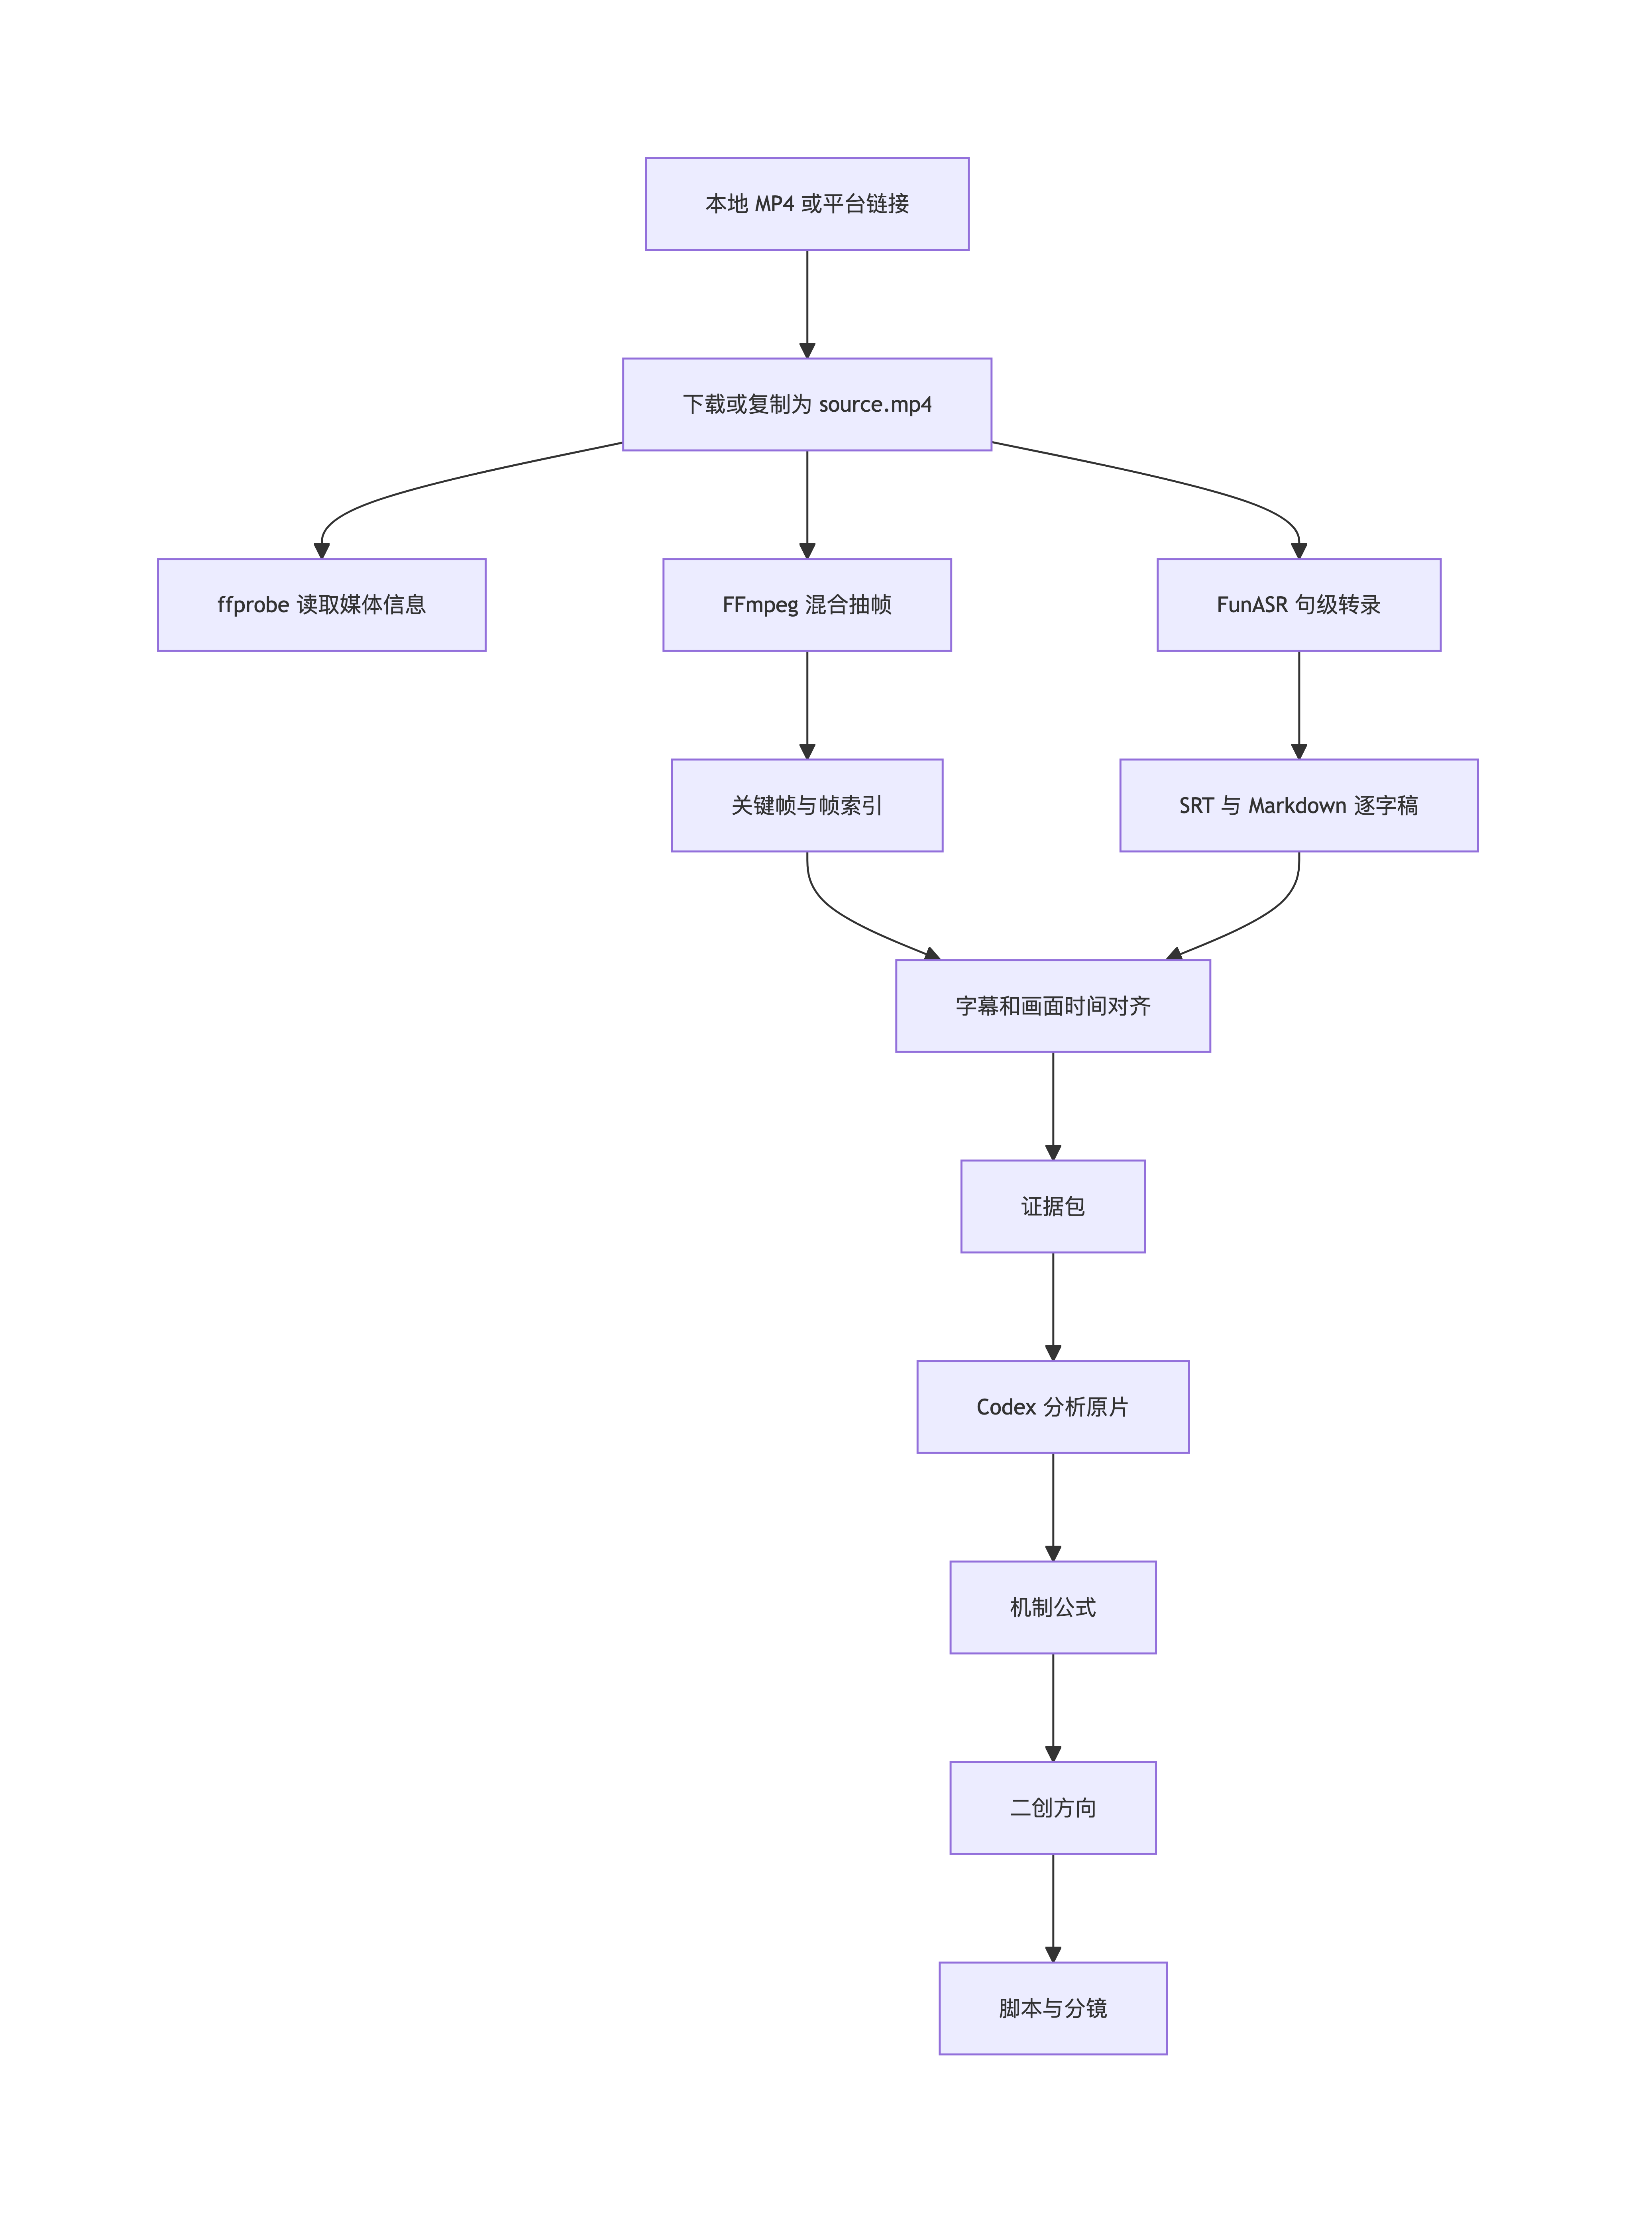
字幕回答说了什么,关键帧回答演了什么,时间线把两份证词进行轨道对接。Codex 接手的是一套可以定位、回查和修改的材料,某个品牌名转录错了,可以修正字幕;某张图判断错了,可以查看原图;报告说第三秒发生反转,也能立刻找到视频中对应的台词和画面。
视频怎样变成证据
预处理由四个 Python 脚本完成,每个脚本只负责一类确定性工作,失败时停止,成功时留下文件。
download_video.py取得本次输入对应的视频。prepare_video.py探测媒体并生成视觉材料。transcribe_funasr.py产生句级字幕。build_timeline.py把台词与附近关键帧关联。
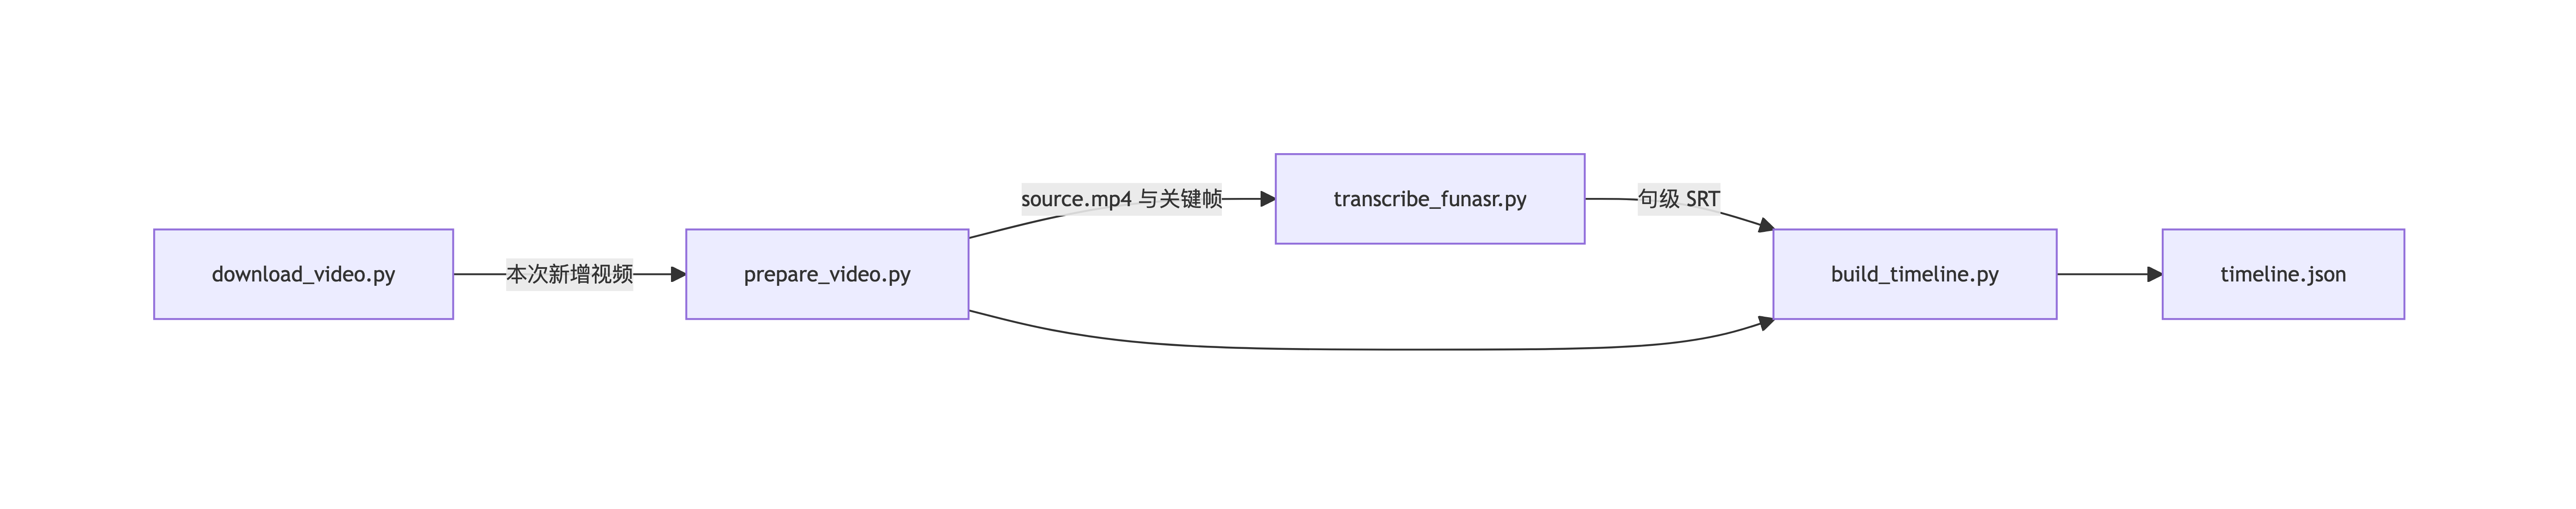
下载环节先做目录快照,再调用对应平台的下载器,最后比较文件修改时间和大小,只返回本次新增或发生变化的视频。若下载器没有产生新文件,任务就停止;如果一个链接返回多个视频,就把选择权交回使用者。
视觉采样也没有采用单一固定间隔。前三秒每 0.5 秒取一帧,以保留开场钩子;FFmpeg 场景检测留下切镜,全片每 2 秒补一帧,照顾没有明显转场的长镜头;结尾再留一帧。相距不超过 0.18 秒的候选帧会合并,默认上限为 48 张,开头、结尾与场景变化帧优先保留。短视频的视觉信息分布很不均匀,前三秒可能换三次画面,中段却十秒没有切镜,平均抽帧看似公平,对内容而言就未必可靠了。
hook_end = min(3.0, duration)
time_sec = 0.0
while time_sec <= hook_end:
    add_candidate(candidates, time_sec, "hook", duration)
    time_sec += 0.5

for time_sec in scene_times(ffmpeg, source, 0.30):
    add_candidate(candidates, time_sec, "scene-change", duration)

time_sec = 0.0
while time_sec < duration:
    add_candidate(candidates, time_sec, "uniform", duration)
    time_sec += 2.0

add_candidate(candidates, duration - 0.05, "ending", duration)
selected = limit_candidates(merge_candidates(candidates), 48)
每张图片的时间戳与入选原因写入 frames/index.json,全部关键帧另排成 contact-sheet.jpg。
字幕时间不能靠分配
音频先由 FFmpeg 转成单声道、16 kHz、PCM 16-bit WAV,临时文件在任务结束后删除。FunASR 同时使用 VAD、中文识别和标点模型,VAD 把长音频切成最长约 30 秒的语音段,识别模型接收人名、品牌和术语热词,标点模型恢复句子边界。多个热词会合并为空格分隔字符串,这个细节曾经造成过实际兼容问题,故保留在脚本里。
转录时必须请求 sentence_timestamp=True,每个句子也必须带有 start 与 end。把视频总时长平均分给每句话,虽然能得到一份格式端正的字幕文件,但代价是台词与画面从此错位,后续分析只是在精确使用假数据。
generation_args = {
    "input": str(wav),
    "batch_size_s": 300,
    "sentence_timestamp": True,
}

if hotwords:
    generation_args["hotword"] = " ".join(hotwords)

results = model.generate(**generation_args)

for item in results[0].get("sentence_info", []):
    if item.get("start") is None or item.get("end") is None:
        raise RuntimeError("缺少句级时间戳")
build_timeline.py 读取 SRT 与帧索引,对每段台词向前、向后各扩展 0.25 秒,把落入时间范围的图片关联进来;范围内没有图片时,选择距离字幕中点最近的一帧。时间线中的 visual_observation 和 on_screen_text 初始为空,空值只表示尚未看图,不能被解释成画面里没有内容。
associated = [
    frame
    for frame in frames
    if segment["start_ms"] - window_ms
    <= round(frame["timestamp_sec"] * 1000)
    <= segment["end_ms"] + window_ms
]

if not associated:
    midpoint = (segment["start_ms"] + segment["end_ms"]) / 2000
    associated = [min(
        frames,
        key=lambda frame: abs(frame["timestamp_sec"] - midpoint),
    )]
这四步跑完后,单条视频项目会留下如下目录。对话回答容易被下一次对话淹没,文件却可以反复查看、局部重做,也可以交给下一位协作者继续处理。
demo-video/
├── source.mp4
├── transcript.srt
├── transcript.md
├── frames/
│   ├── index.json
│   └── frame_*.jpg
├── contact-sheet.jpg
└── timeline.json
以下命令中的 SKILL_DIR 和 PROJECT_DIR,分别指向 Skill 目录与单条视频项目目录。
SKILL_DIR="/path/to/short-video-remix"
PROJECT_DIR="/path/to/video-analysis/demo-video"

python3 "$SKILL_DIR/scripts/download_video.py" "<平台链接或分享文本>"

python3 "$SKILL_DIR/scripts/prepare_video.py" \
  "<本地 MP4 路径>" \
  --project-name "demo-video"

python "$SKILL_DIR/scripts/transcribe_funasr.py" \
  "$PROJECT_DIR/source.mp4" \
  --out-dir "$PROJECT_DIR" \
  --hotword "<人名、品牌或术语>"

python3 "$SKILL_DIR/scripts/build_timeline.py" "$PROJECT_DIR"
Codex 怎样完成二创
所以得原视频拆解素材准备好之后,Codex 依次读取 transcript.md、timeline.json 和 frames/index.json,查看联系表,再检查开场、场景变化、冲突、产品展示和结尾行动号召附近的原始帧。阅读顺序有实际作用,字幕先给出语言主线,时间线补上视听关系,原始图片再纠正缩略图可能造成的误判。
分析文件中,事实、推断和创作建议必须分开。语音事实附时间码,画面事实附关键帧文件名,作者意图和传播机制则标成推断。
[语音 00:03.200–00:05.800]
“真正让你疲惫的,可能不是工作本身。”

[画面 frames/frame_008_00-00-04-000.jpg]
人物正对镜头,办公室背景,中央出现大字标题。

[推断]
开场重新命名观众熟悉的痛点,以认知落差争取停留。
这个标记虽然很普通,但是能挡住大部分模型乱说。模型常见的问题并非蓄意虚构,它只是会把推测写得像正经发文一样。
整个创作阶段依次生成五份文档,顺序也不可随意调换。
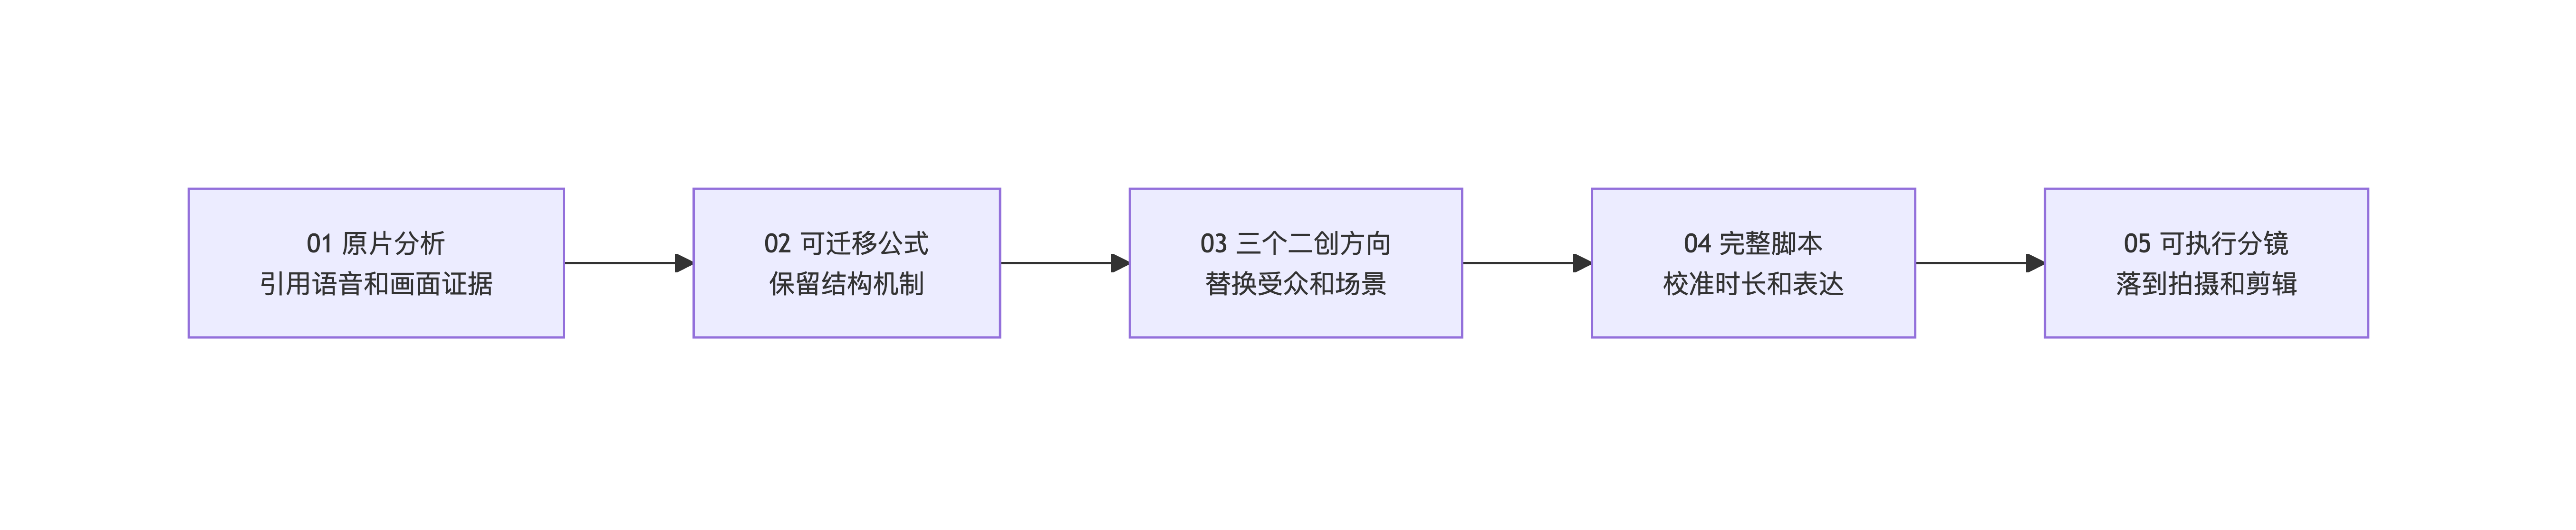
01-source-breakdown.md说明原片的受众、前三秒钩子、信息顺序、冲突、转折、字幕、动作和行动号召,每个重要判断都引用证据。02-transferable-formula.md删除人物、品牌、案例与独特措辞,留下可替换的结构,例如“熟悉痛点 → 反常识判断 → 三个自查症状 → 隐藏根因 → 可执行动作 → 身份认同收束”。03-remix-concepts.md给出三个差异明显的选题方向,比较受众、痛点、视觉场景和制作难度。04-remix-script.md再写标题、封面、前三秒、完整口播、字幕断句、停顿和 CTA。05-storyboard.md最后把台词落到镜号、时间、景别、动作、屏幕字幕、转场、声音和素材来源上。
最后先出三个方向很有必要,如果直接让模型写全文,常常不会很满意,多个方向输出就类似于文生图时的抽卡一样,抽到自己满意为止。
一段可直接使用的提示词
安装这个Skill之后,可以使用下面的提示词使用。包括输入目录、目标受众、时长、表达风格和交付文件。
使用 $short-video-remix 完成现有视频项目的分析与二创。

视频源文件:/path/to/video-analysis/demo-video/demo.mp4

创作要求:
- 目标平台:抖音
- 目标受众:长期加班、注意力分散的职场人
- 目标时长:60 秒
- 表达风格:克制、直接,带一点黑色幽默
- CTA:引导观众说出最消耗自己的环境因素

请区分语音事实、画面事实、推断和创作建议。
重要判断必须标注时间码或关键帧路径。

依次生成:
01-source-breakdown.md
02-transferable-formula.md
03-remix-concepts.md
04-remix-script.md
05-storyboard.md
二创的质量门槛可以归纳为四次核验,任何一个核验不满意,都要退回上一份文件修改。
- 证据核验检查重要判断能否回到字幕和原图。
- 结构核验检查模型是否提炼出可替换变量的机制,抑或只做了同义词替换。
- 差异核验检查受众、案例、措辞和视觉设计是否形成独立表达。
- 制作核验检查字数是否匹配时长,每段话是否有画面承接,分镜能否直接交给拍摄与剪辑。
这份 Skill 目前的情况
目前的 short-video-remix 已经可以在本地跑通一条完整流程。输入本地 MP4,或小红书、抖音、B 站链接后,它会取得本次视频,生成带时间戳的逐字稿、混合采样的关键帧、帧索引、联系表和统一时间线;Codex 再读取这些证据,依次产出原片分析、可迁移公式、三个二创方向、完整脚本与可执行分镜。使用者最终得到的是一组可以回查、修改和继续协作的项目文件。
现阶段的成品边界也比较清楚。预处理只接受 MP4,默认最多保留 48 张关键帧;屏幕文字由 Codex 查看图片识别,尚未另接 OCR;音频侧完成中文转录,尚未分析 BGM 的 BPM、音高和音量包络;评论、互动、账号历史及行业数据不在默认范围,因而可以说明视频采用了哪些内容设计,尚不能宣称某项设计导致了爆款。脚本与分镜是当前终点,自动成片、发布和效果归因仍需接入后续制作与运营系统。
该Skill已在 Github 项目中开源,项目地址: https://github.com/xuflyme/short-video-remix